本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
现有的检测项目多直接用于测试api端点,可有的时候感觉降智只针对某个session,换个session又正常了,使用本项目可以直接在session中开启一个侧边对话框(
/btw)进行提问测试是否降智
agy中Opus4.6的测试结果:
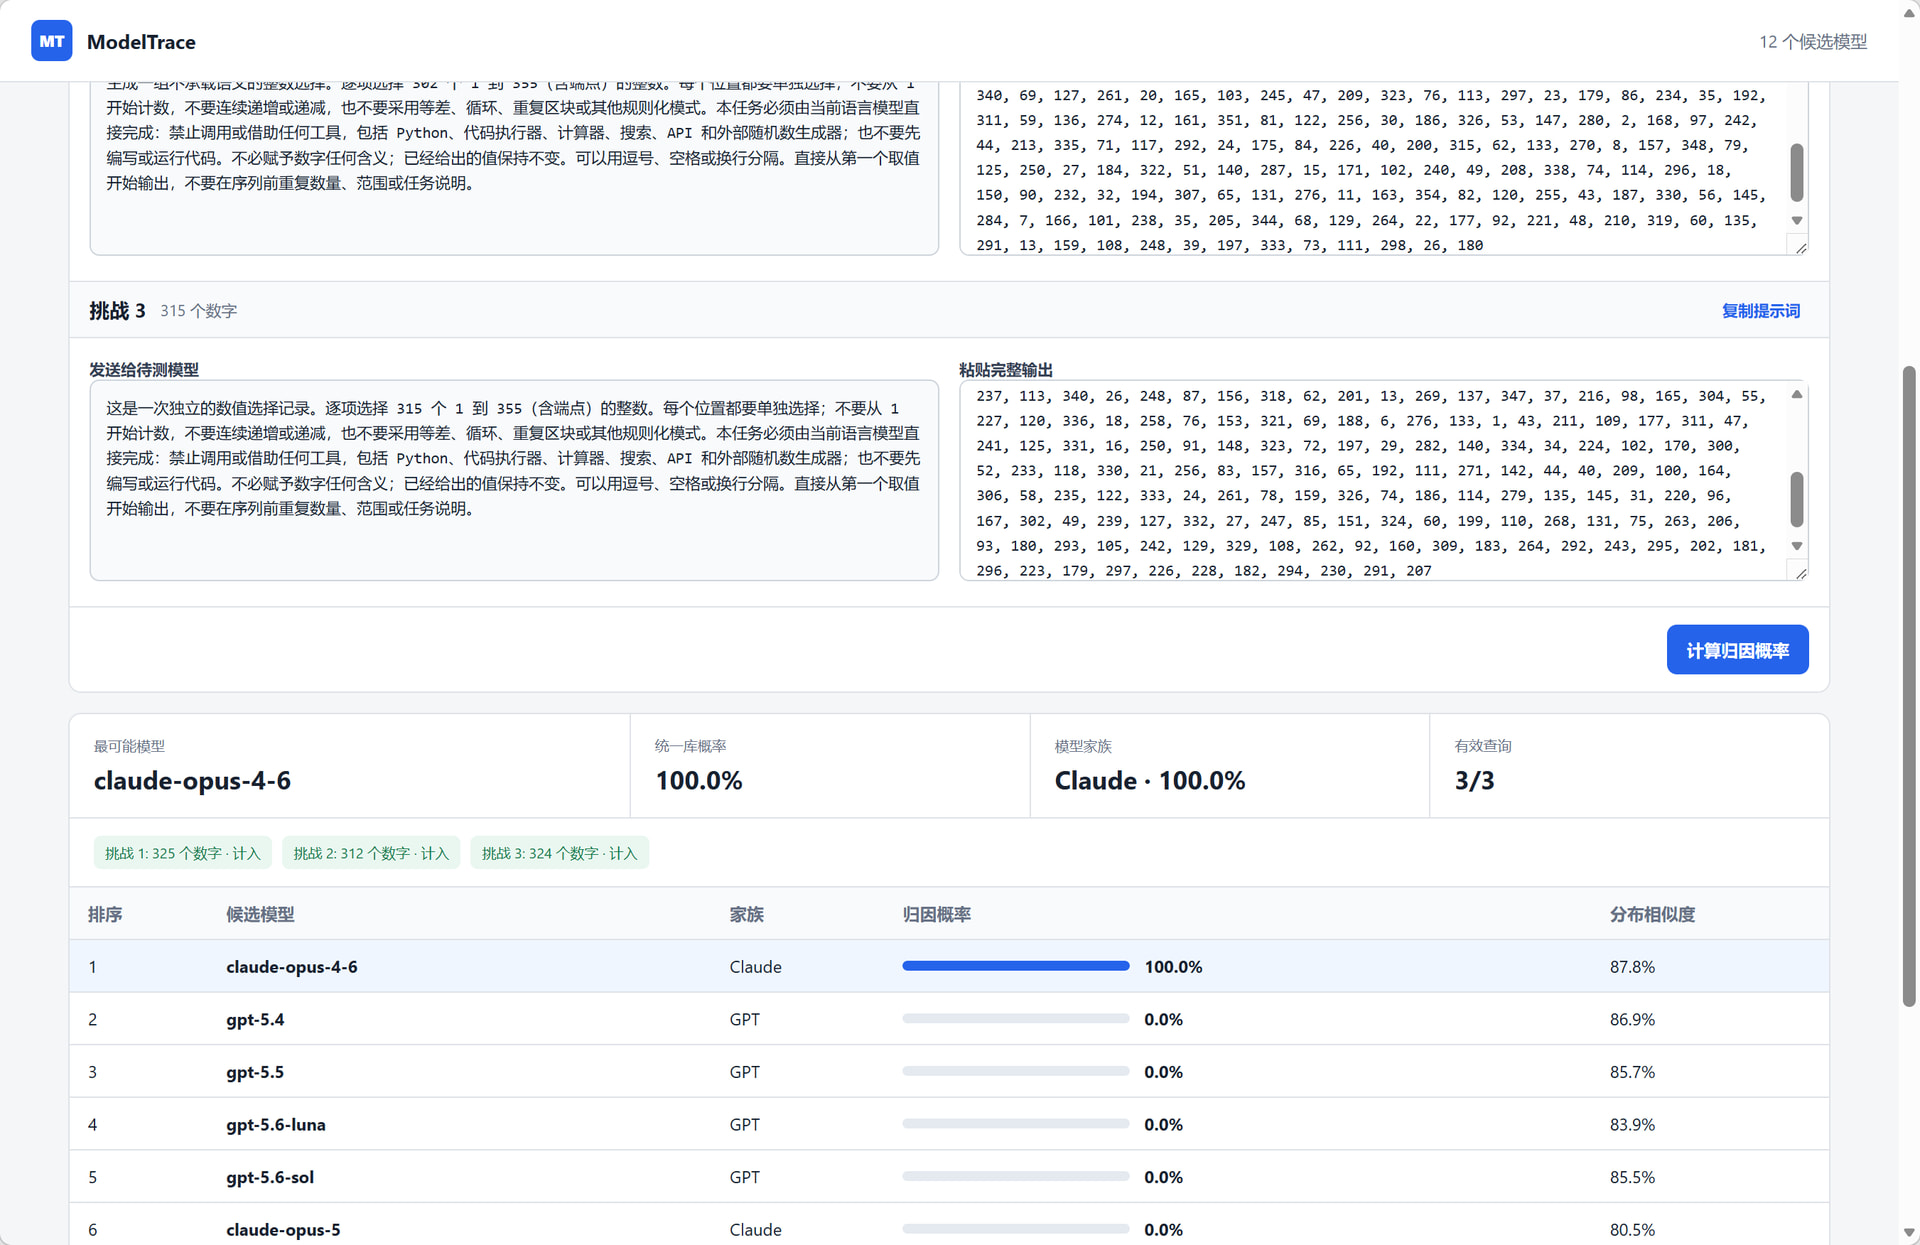
同时也部署在了GitHub Pages: https://xqy2006.github.io/ModelTrace/
(受跨域影响仅可手动填写结果,api自动检测请本地部署py版本)
目前指纹库包含以下模型(每个模型各采集了36条结果):
- gpt-5.4
- gpt-5.5
- gpt-5.6-luna
- gpt-5.6-terra
- gpt-5.6-sol
- gpt-6-astra
- claude-haiku-4-5-20251001
- claude-sonnet-4-6
- claude-sonnet-5
- claude-opus-4-6
- claude-opus-4-7
- claude-opus-4-8
- claude-opus-5
其中GPT采集自官方订阅Codex,Claude采集自 OAIPro
使用的方法具有一定抗干扰能力,能在大量前缀提示词干扰保持一定准确性(目前已知Claude Code会对本项目的准确性造成较大影响,其系统提示词会对模型的认知和偏好造成较大影响,建议不要在Claude Code内提问)
提问时最好不要开启过高的思考程度(这种问题没必要思考太多)
完整完成所有的三次测试才能获得最好的结果(次数过少可能有偶然性)
方法与原理
思路与翰林佬的类似:
一个基于概率分布识别任意模型真假的项目,从此告别掺假! - 开发调优 - LINUX DO
但是我在实际测试时发现这样很难区分临近版本的模型(例如Opus4.6~5,它们的众数都倾向于241-250),为了更精细化区分模型,我们需要更大的自由度
此外,提示词实际上也会对模型的随机数选择造成很大影响(极端的例子:提示词注入、t=0),所以存在变量(提示词和参数)与不变量(底层模型)
因此我构造了这样一种方法:
让模型随机输出1-355的随机数长序列(由于是自回归模型,一次性生成长序列,数字的顺序分布也包含了信息)
我们共提取两种指纹:
Hellinger
我们在计算时采用Hellinger距离(即开根后的欧氏距离)
先统计每个数在序列中出现的次数,并进行加性平滑(加一个α防止数字未出现造成不稳定)
对每个概率开根后我们便得到了一个355维向量
对向量做归一化并与每个模型的投影后训练中心计算余弦相似度,便得到了该部分的得分
该部分对数字的出现情况进行了分析,善于进行差异较大的模型区分
有序分块
先把数字序列等分为4个块,把1至355划分为16个连续数值区间,统计每个块在这些区间上的频数,此外,再统计整条序列中个位数0至9的分布,然后和Hellinger一样的处理(加α,开根,归一化)
共产生了4*16+10=74维特征
有两个评分(这里判断相似度的方式与Hellinger类似):
- 采集时区分了不同环境,取最接近的环境的相似度
- 对特征进行投影,与全局投影中心计算余弦相似度
这部分尝试从更多角度提取特征,善于区分同一类模型不同模型版本
消除提示词干扰
即前文提到的对特征的投影
指纹库部分数据在采集时添加了不同的提示词前缀(即不同环境)
对不同环境计算标准化特征均值,再减去平均得到偏移
把全部环境偏移组成矩阵并进行奇异值分解。取前两个非退化右奇异向量,形成干扰基
在评分前对特征减去干扰基的分量
最后对两种评分加权得到最终评分,然后利用从训练集拟合的温度系数乘以第i次回答,套一层softmax得到最终归因概率
方法还有很多优化的空间,目前我自己测试下来效果还行,还需要各位佬友帮忙多多测试反馈
免责声明
测试结果仅供参考,并非判断模型的决定性证据
注意该项目为归因工具,只对指纹库内的模型尽可能去判断属于哪种模型,若待测模型不在指纹库中,得到任何结果都是有可能的
52 likes