历史贴:
https://x.com/AstroHanRay/status/2083918530605707459?s=20
同一道题、同一个 DeepSeek,常规 Harness 要花 100 美元,我们做到 12.5 美元,通过率还反高十几个点。我们把结果拆开讲:开源 Agent Harness「Maka」怎么用一套事件日志架构,把最省钱、最省 token、最适配国模三件事同时做到——每一件都有代码层的机制,每一件都有公开跑分背书。
我们做了什么
- 开源 Agent Harness「Maka」,local-first,Apache-2.0,TypeScript。
- 一个 Runtime 覆盖 Desktop / TUI / CLI / Headless 四端,同一套模型连接、权限、会话跨端共享。
- 同一 DeepSeek V4 Flash 一道题,成本做到 OpenCode 的 1/8。
- Terminal-Bench 2.1 每通过一题 0.03215 美元,四臂(Codex / CC / Reasonix)最低。
- 同一 K3 模型,Maka 69.7%,官方 KimiCode 59.6%。
项目地址:https://github.com/maka-agent/maka-agent
2.5 个月,1,240+ Star,49 位贡献者,v0.1.4 发版后 23 小时合入 83 个 PR。社区群 200 人已满,正在开 2 群。
一、Agent 的钱烧在哪:四个环节,每个都是 Harness 的优化空间
模型 API 定价逐年走低,跑 Agent 的账单没跟着降。钱烧在四个环节,每个都归 Harness 管:
- thinking 反复重推。上一步已经想过的推理,下一步又从头想一遍。
- 工具结果重复读。同一段代码、同一份输出,模型读了一遍又一遍。
- 提示词与工具面冗余。20KB 产品提示词 + 全量工具面,每轮都在给无关内容付费。
- 缓存命中率低。历史全量重传,没吃上 provider 的缓存折扣。
Maka 的省钱,来自一套把这四个环节一次性解决的设计。先讲设计,再讲机制。
二、技术底色:四条设计信条
Maka 的所有工程决策收敛成四条信条,写在架构文档里。理解它们,就能理解后面的每个数字。
1. Log is the Runtime(日志即运行时)
模型消息、工具调用、工具结果、终止原因,全部落进 Runtime Event Log。会话、UI、模型上下文、崩溃恢复,都是这份日志的投影(projection)。
Desktop / TUI / Headless
↓
SessionManager → AgentRun → Model + Tool Runtime
↓
Runtime Event Log → Context / Session / UI 投影
↓
Task Event Log → TaskRun → Self-check / AHE
好处直接落在工程上:崩溃从日志重建执行状态;跑分、故障复盘、token 用量都能从日志反查。同一个日志驱动四个入口。
2. Context is not history(上下文不是历史)
模型下一次看到什么,由 Context 层决定;已记录的执行事实保留在事件日志里。该省上下文的时候省,要回查的时候能读回。
这条信条直接催生了下面的 Context-budget 剪枝。
3. A task may outlive a Turn(任务可以活过一轮对话)
Headless 用 TaskRun + Task Event Log + 预算 + continuation 支撑可中断、可检查、可恢复的持久任务。跑一半断电断网,能接着跑。
4. Feedback is not fact authority(反馈不等于事实)
Self-check 会产生证据,给一次有界的修复机会。"我检查过了"不会自动升级成系统事实。防止 Agent 自我确认偏差污染执行记录。
三、最省钱:三个机制,拆到实现层
机制 1:Thinking 重放协议,省掉重复思考
做 benchmark 时,我们从遥测里挖出一个协议层问题,它直接解释了早期 Maka 比 Codex 烧 token 的差距。
Maka 的模型适配层在 packages/runtime/src/model-adapter.ts:141 的 runtimeEventReplaySupport() 里有三个开关:
- signedThinking:仅 Anthropic
- unsignedThinking:仅 Kimi
- openAiResponsesThinking:仅 Responses API
DeepSeek 走 openai-chat 路径,三个开关全为 false——每步把模型过往的 thinking 从 prompt 里删掉。后果在遥测里是单调的:
模型每步都在重新推导"上一步已经想过的东西",历史越长重推越贵。
修复:统一加 ReasoningReplayContract,DeepSeek 切到 Responses API 保留 thinking。修完团队原话:"快太多了"。
Kimi K3 官方博客写了同一件事:harness 不完整回传 thinking,生成质量会严重不稳定。协议层的一行开关,直接决定效果和账单。
机制 2:Context-budget 剪枝,省掉重复读
工具输出常比模型输入还长。Maka 的 Context 层做剪枝:超过 2048 token 的工具结果替换成占位符并归档,模型需要时再读回。
121 组 Terminal-Bench 任务 A/B 实测:
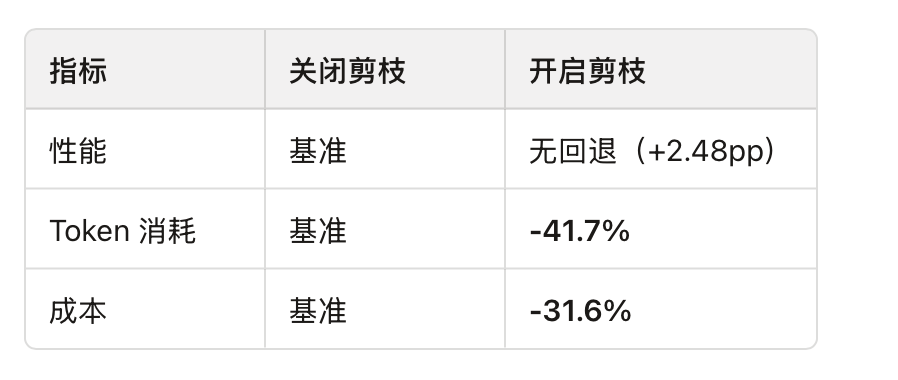
省 41.7% token,性能不降反升。
机制 3:精简系统提示词 + 精简工具面
跑分时 Maka 的系统提示词只有 253 字节、4 行;KimiCode 是约 20KB 产品提示词 + 全量工具面。前台工具只暴露 Read / Write / Edit / Bash / Glob / Grep 六个。
每轮省下几千 token 的提示词开销,模型注意力也不被无关工具稀释。
数据收口
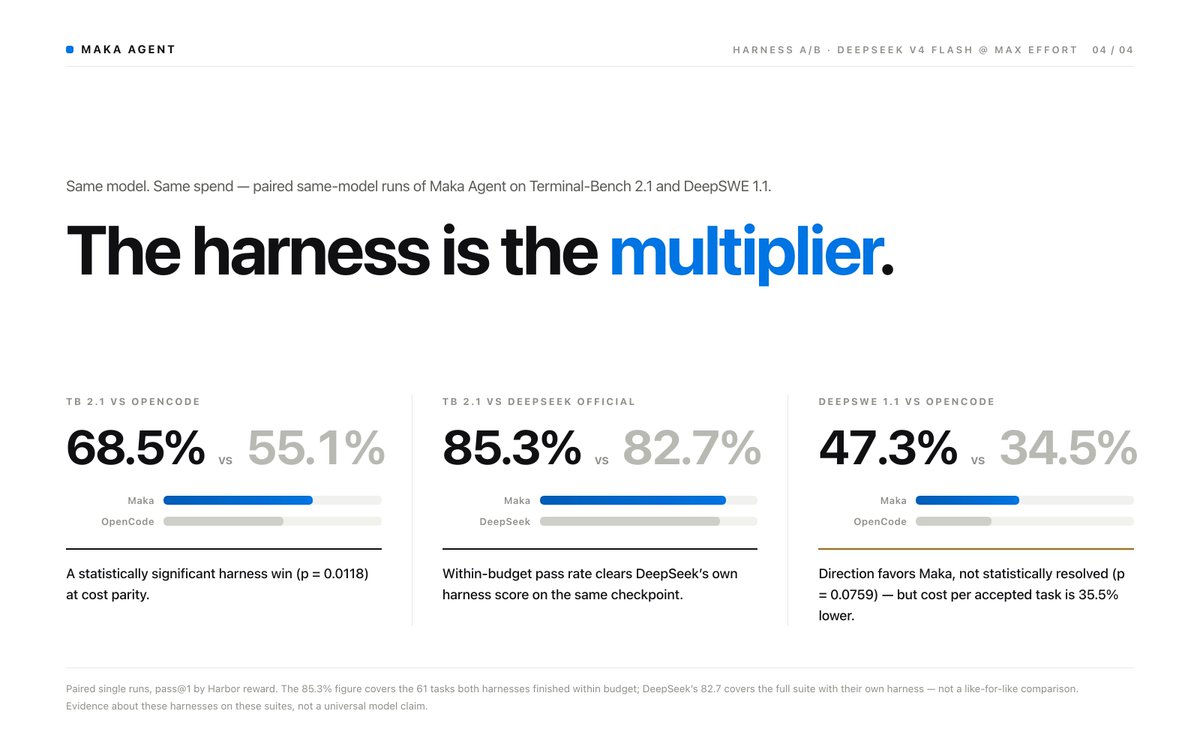
- 同一 DeepSeek 一道题,成本约 OpenCode 的 1/8。
- 四臂跑分里,Maka 用 Codex 61% 的输入 token 拿到 93% 的分数。
- 输入缓存命中率 97.93%(DeepSeek 缓存命中输入价格是未命中的 2%)。
四、最适配国模:五个技术证据
证据 1:同一 K3,反超官方 harness 10.1 个百分点
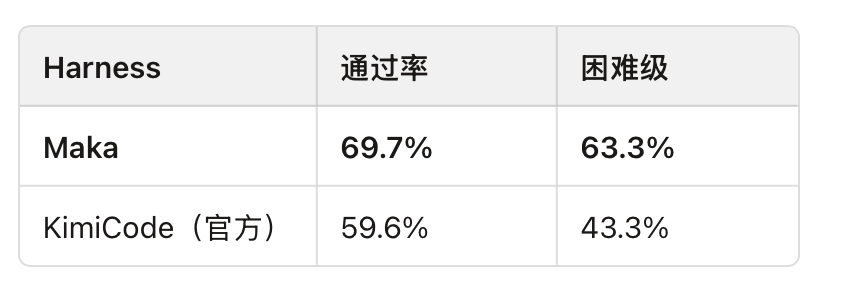
同一 K3 模型、max 思考档位、thinking 双端保留。差距来自 Maka 针对 K3 的 thinking 敏感性做的完整回传适配(机制 1),加上精简工具面(机制 3)。
证据 2:每个模型的 thinking 协议差异,逐一适配
DeepSeek、Kimi、GLM 对 thinking 的协议要求各不相同:K3 对思考历史极度敏感,DeepSeek 要求 thinking 全回传。Maka 的适配不是"一套配置打天下",而是逐家对齐协议差异,并统一收进 ReasoningReplayContract,后续不漏适配。
证据 3:DeepSeek 内置联网搜索
Maka 在 DeepSeek API 请求参数里声明 web_search tool,直接用 API 端搜索能力,无需对接第三方搜索引擎。用 DeepSeek 模型时开箱即用。
证据 4:缓存命中率,直接省钱
群里做过缓存利用率对比:Claude Code 的缓存利用率比 Codex 差不少。Maka 的四臂跑分里输入缓存命中率 97.93%,把 DeepSeek 的 2% 缓存折扣吃到接近满格。
证据 5:模型厂反向关注
DeepSeek 官方公开招募 Agent Harness 开源项目参与官方 Harness 内测,Maka 报名。开源 harness 被模型厂主动找来共建,是对"适配国模"的背书。
五、数据验证:怎么测的,和测出什么同等重要
逐题 CSV 和完整方法都在:
- https://github.com/maka-agent/maka-agent/pull/1719
- https://github.com/maka-agent/maka-agent/pull/1848
- https://github.com/maka-agent/maka-agent/pull/1916
所有数据来自仓库 docs/eval/ 下的公开报告,口径统一:
- 同一模型、同一任务容器、同一 deadline,唯一变量是 Harness;
- pass@1 以官方 verifier 结果为准;
- 显著性用 McNemar 精确检验,六组对比报 Bonferroni 修正后的阈值 0.0083;
- 成本用 cache-aware 定价估算(0.145 美元/M 未命中输入、0.0029 美元/M 缓存命中输入、0.29 美元/M 输出);
- 污染格、基础设施异常、重试逐条披露。
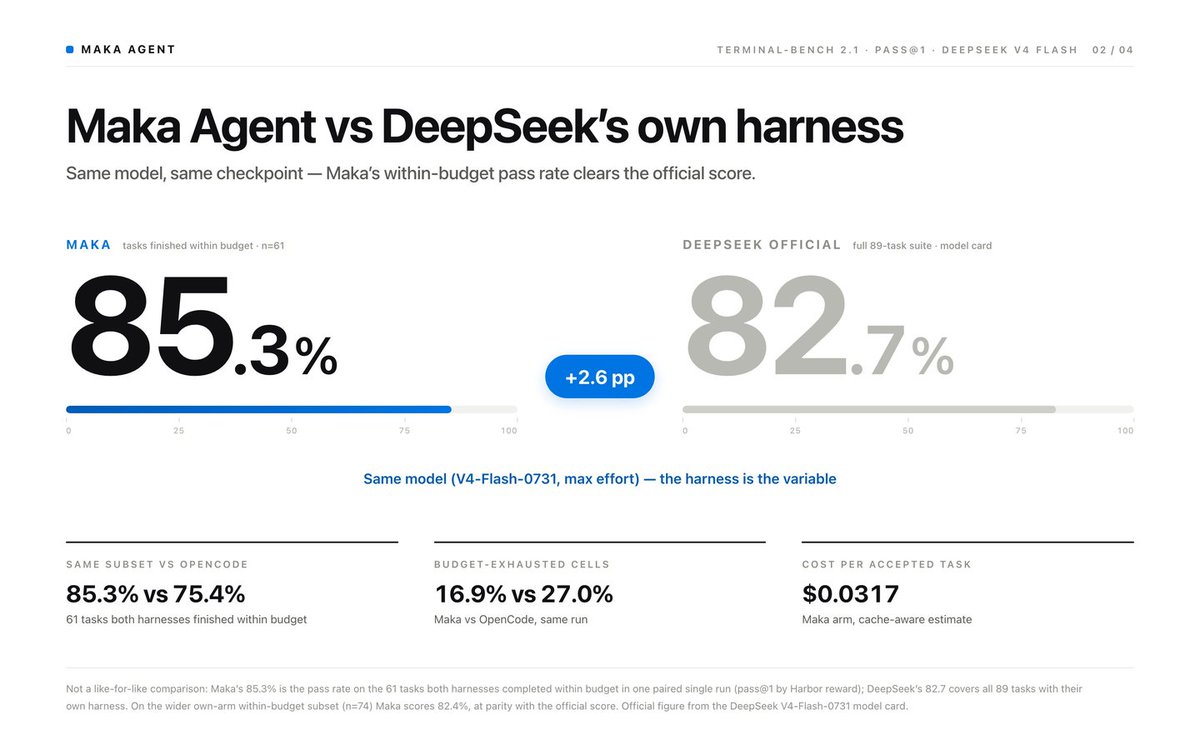
四方对比(DeepSeek V4 Flash × TB2.1 × 89 题)
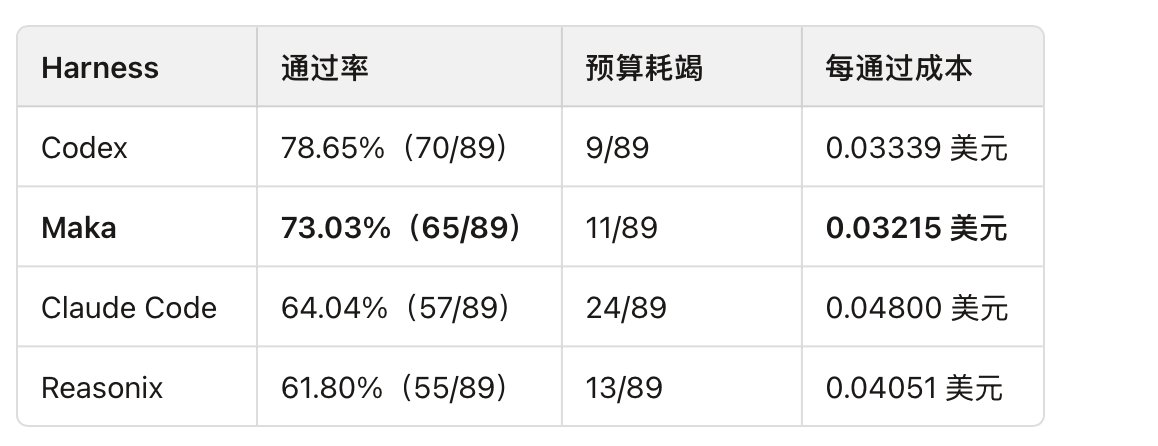
Codex 与 Maka 的 5 题差距,McNemar 检验 p=0.359,落在噪声范围内;Maka 每通过一题成本最低、中位完成最快(332.8s vs 411.7s)。
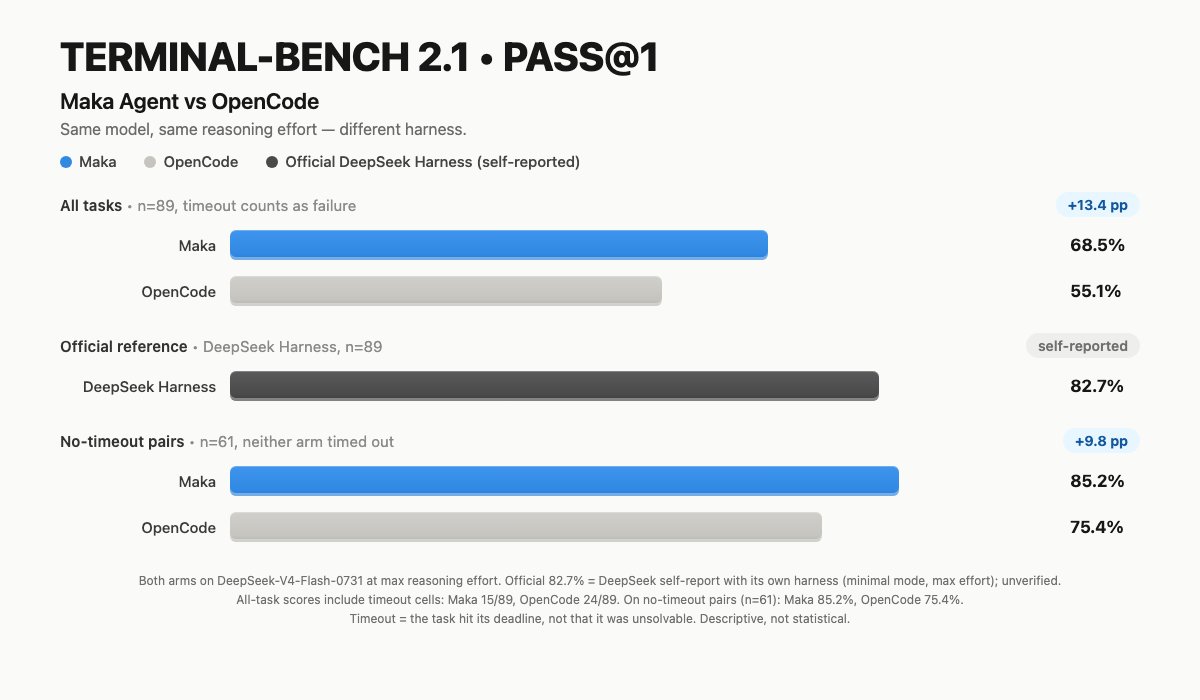
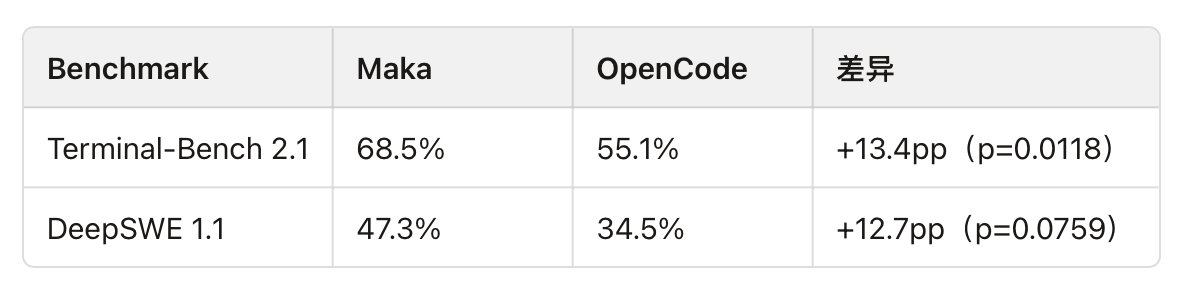
vs OpenCode(DeepSeek V4 Flash)
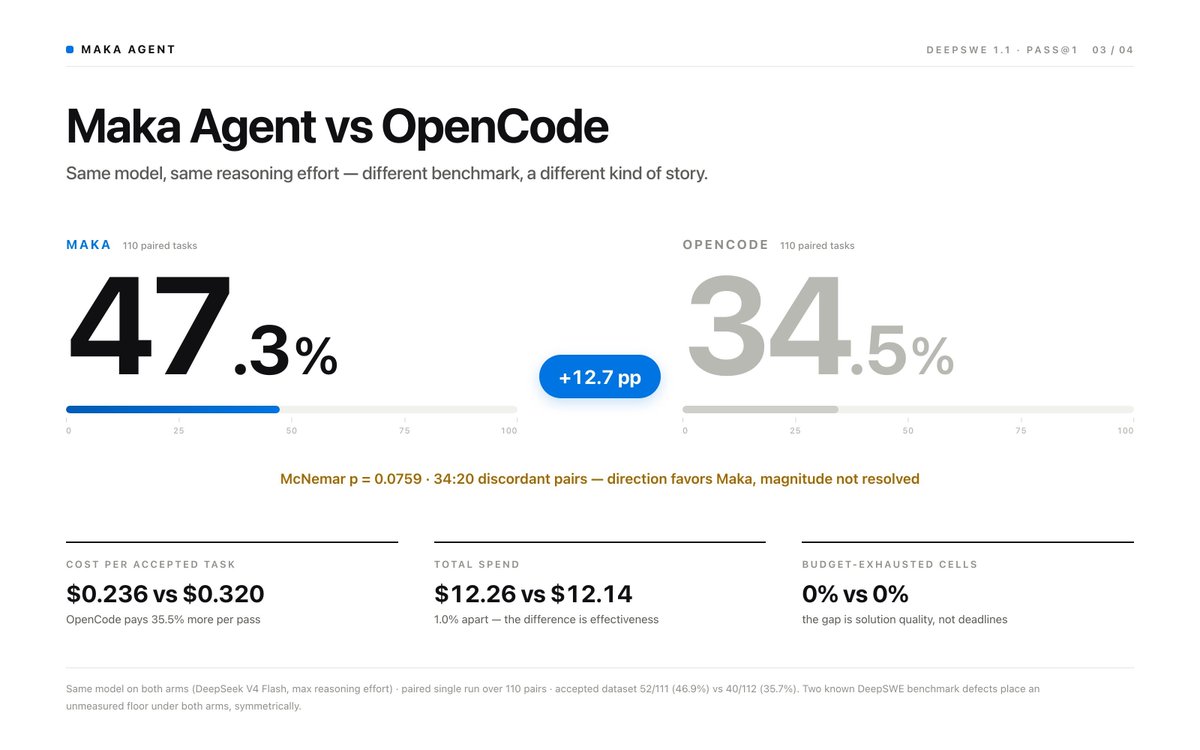
DeepSWE 两边预算耗竭率都是 0%,差距来自执行质量与验证策略,每通过一题成本 Maka 0.236 美元 vs OpenCode 0.320 美元。
K3 报告:吞吐压制的下界,仍反超官方
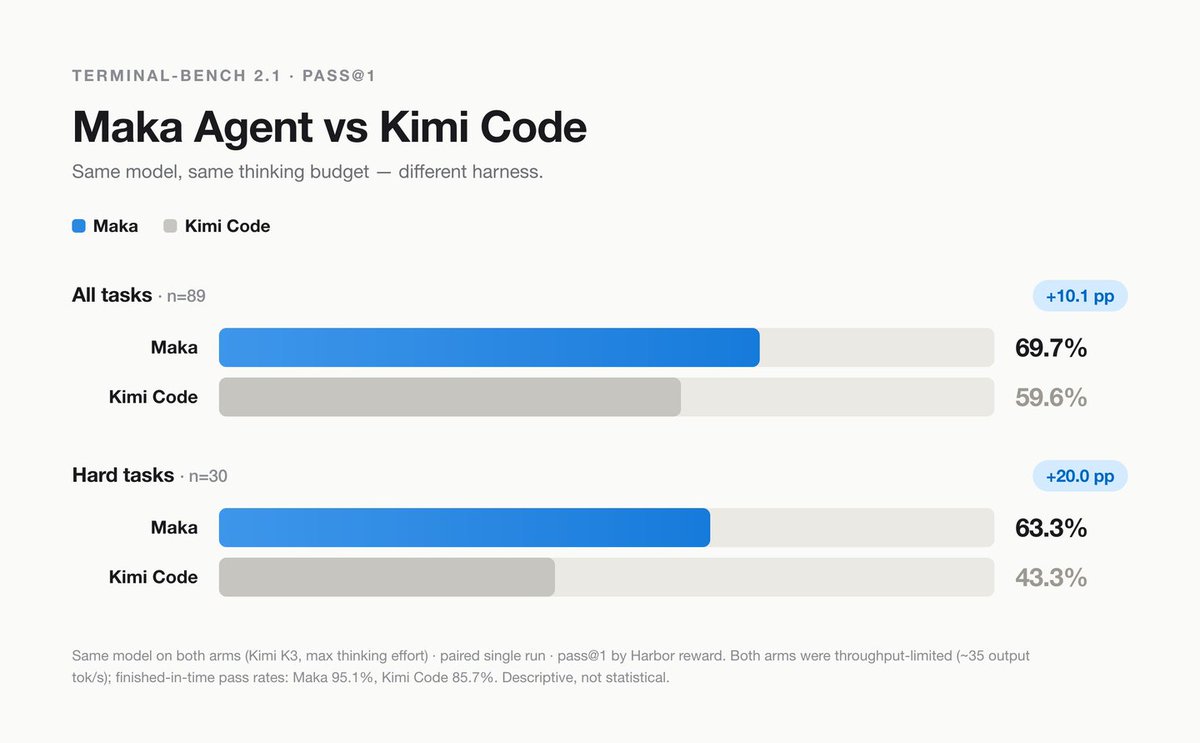
K3 那轮跑分受网络吞吐压制,两边绝对分数都是下界。即便在这种环境里,Maka 及时完成的任务通过率 95.1%,KimiCode 85.7%;全量 89 题 Maka 69.7% vs 59.6%。同一个模型,结论一致。
六、演进速度:架构在重构,问题在社区里消失
2.5 个月、49 位贡献者,这个项目以周为单位迭代:
- v0.1.4 发版后 23 小时合入 83 个 PR(#1872 → #2150);发版频率一度一天两版。
- runtime-host 架构重构(第一个架构大重构):把散落在各处的所有权收进 runtime host,Desktop / CLI / Headless 共享同一个运行时底座。
- swarm → graph 收编:早期 swarm 有主 agent 无法中途介入、timeout 不降并发、错误分类不一致三个缺陷,重构后改成异步 spawn,整体收进 graph(DAG 编排,主 agent 观察推进)。
- DB 兼容问题靠社区 PR 修:#2263 / #2363,前后版本不删库、会话不丢。
- 贡献者里 jackwener 1,568 次、Astro-Han 759 次、likun666661 253 次提交领跑。
团队主力多是 00 后:"我们才几个人啊,所以侧面说明就是要开源,让大家来帮忙。"
七、我们还在做:三个方向
1. @ai-sdk/code-mode 评估
自研工具执行器里最贵的一块是"完整 JS 语义 + TS 类型擦除 + 内存/超时限制"。AI SDK 官方出了 @ai-sdk/code-mode:QuickJS 隔离、JS 与 type-stripped TS、内存/栈/总时间/源码/输入输出/调用数硬限制、experimental_toolCallers把受管工具从 provider surface 隐藏。
它能不能直接替换,取决于能否保住 Maka 的这几个不变量:
- 每个嵌套调用仍进入 ToolRuntime.settleToolCallRaw;
- permission / sandbox 请求可以异步停车;
- abort 后不留晚到副作用;
- durable commit failure 能穿透 QuickJS bridge;
- nested activity 不污染 provider replay;
- Electron / CLI / headless 都能加载 QuickJS worker/WASM。
AI SDK 文档声称不支持标准 nested approval flow,但 Maka 的 approval 在自有 ToolRuntime 内,需要实际 permission-suspend 测试验证,不能靠文档下结论。
2. Graph / Agent Swarm:多 Agent 编排
Graph 是 Maka 的实验特性:主 agent 把任务划分编排成 DAG,每个节点是一个 subagent,主 agent 在旁边观察、推进。实测 32 个 subagent 并发读代码,体验比 swarm 更好。
3. 走向云 Agent
群里反复出现一个判断:云 agent 是最终形态。Maka 先在本地把 harness 做到位,再填 Maka Cloud 的坑——桌面、终端、云端多端一体。
结论
Agent 成本的真相:模型很便宜,会用模型才便宜。
Maka 把钱省在机制上,逐条对应四个烧钱环节:
- thinking 重放协议——DeepSeek 切 Responses API,reasoning 曲线从单调爬升拉平,省掉重复思考;
- Context-budget 剪枝——2048 token 阈值 + 归档恢复,token -41.7%、性能 +2.48pp;
- 精简提示词 + 精简工具面——253 字节 vs 20KB,每轮省几千 token;
- 缓存命中 97.93%——历史不白重传。
同一 DeepSeek 一道题成本打到 OpenCode 的 1/8,同一 K3 反超官方 10.1 个百分点。这些数字的每一分,都能在代码和遥测里追到根。
如果你也在跑 DeepSeek / GLM / Kimi,或者被 Agent 账单折磨过,欢迎来:
- 项目:https://github.com/maka-agent/maka-agent(Star、Issue、PR 都欢迎)
- 跑分报告:docs/eval/ 全公开,逐题 CSV 可复核
- 社区:200 人群已满,2 群在开,群里每天都有热烈的技术讨论
Maka 想做的事:让每一个模型,都更省地把能力兑现成结果。
文中所有数据与方法均来自 maka-agent/maka-agent 仓库 docs/eval/ 下的公开报告,可逐题复核。